-
면접을 위한 DB 정리CS 2025. 11. 14. 01:16
이번에 나이스 평가정보 면접을 보며 데이터베이스 공부를 다시 할 기회가 있었다.
(공부한 내용 위주로 면접이 흘러간 것은 아니었다 ㅜㅜ)
공부한 것이 아까워 주요 내용을 블로그에 남기려고 한다! 키워드 위주로~
1. SQL
1-1 행 삽입
INSERT INTO employees (emp_id, name, dept, salary)
VALUES (1, 'Kim', 'IT', 5000);
다른 행에서 SELECT 해서 INSERT 하는 경우
INSERT INTO high_salary (emp_id, name, salary)
SELECT emp_id, name, salary
FROM employees
WHERE salary >= 5000;
1-2 테이블 구조 수정
-- 1. 컬럼 추가 (ADD)
ALTER TABLE employees
ADD birth_date DATE;


-- 2. 컬럼 타입 변경 (MODIFY TYPE)
ALTER TABLE employees
MODIFY salary NUMBER(10, 2);


-- 3. 컬럼 이름 변경 (RENAME COLUMN)
ALTER TABLE employees
RENAME COLUMN name TO full_name;


-- 4. 컬럼 삭제 (DROP COLUMN)
ALTER TABLE employees
DROP COLUMN birth_date;


-- 5. DEFAULT 값 설정/변경
ALTER TABLE employees
MODIFY dept DEFAULT 'IT';


-- 6. NOT NULL 제약 추가/제거
ALTER TABLE employees
MODIFY salary NOT NULL;

ALTER TABLE employees
MODIFY salary NULL;   -- NOT NULL 제거


-- 7. 테이블 이름 변경
ALTER TABLE employees
RENAME TO workers;


-- 8. 제약조건 추가
ALTER TABLE employees
ADD CONSTRAINT pk_emp PRIMARY KEY (emp_id);

ALTER TABLE employees
ADD CONSTRAINT uq_phone UNIQUE (phone);

ALTER TABLE orders
ADD CONSTRAINT fk_emp
  FOREIGN KEY (emp_id) REFERENCES employees(emp_id);


-- 9. 제약조건 삭제
ALTER TABLE orders
DROP CONSTRAINT fk_emp;
1-3 테이블 업데이트
-- 1. 가장 기본적이고 가장 중요한 UPDATE 패턴
UPDATE employees
SET salary = salary + 500
WHERE emp_id = 1001;


-- 2. 조건을 통해 여러 행을 선택적으로 업데이트하는 형태
UPDATE employees
SET dept = 'HR'
WHERE dept = 'IT';
1-4 튜플 삭제
DELETE FROM employees
WHERE emp_id = 1001;
1-5 행 삽입 시 중복이 발생했을 때
-- 1. (Oracle) 중복 발생 시 INSERT 대신 MERGE 사용
MERGE INTO employees e
USING (SELECT 1001 AS emp_id, 'Kim' AS name FROM dual) src
ON (e.emp_id = src.emp_id)
WHEN NOT MATCHED THEN
    INSERT (emp_id, name)
    VALUES (src.emp_id, src.name);
-- 중복(emp_id 동일)일 경우 INSERT 실행 X


-- 2. (PostgreSQL) 중복이면 INSERT 건너뛰기
INSERT INTO employees (emp_id, name)
VALUES (1001, 'Kim')
ON CONFLICT (emp_id) DO NOTHING;

-- 3. PostgreSQL의 UPSERT: 중복 발생 시 UPDATE 실행
INSERT INTO employees (emp_id, name, salary)
VALUES (1001, 'Kim', 5000)
ON CONFLICT (emp_id)
DO UPDATE SET
    name = EXCLUDED.name,
    salary = EXCLUDED.salary;


-- 4. 특정 컬럼만 업데이트하고 싶을 때
INSERT INTO employees (emp_id, salary)
VALUES (2001, 4500)
ON CONFLICT (emp_id)
DO UPDATE SET
    salary = EXCLUDED.salary;
1-6 Groupby, Having
-- 1. GROUP BY로 부서별 평균 급여 구하기
SELECT dept,
       AVG(salary) AS avg_salary
FROM employees
GROUP BY dept;


-- 2. HAVING으로 집계 조건 필터링 (평균 급여가 5000 이상인 부서만)
SELECT dept,
       AVG(salary) AS avg_salary
FROM employees
GROUP BY dept
HAVING AVG(salary) >= 5000;
1-7 Join
-- 1. INNER JOIN (양쪽 테이블에서 매칭되는 행만)
SELECT e.emp_id, e.name, d.dept_name
FROM employees e
INNER JOIN departments d
    ON e.dept_id = d.dept_id;


-- 2. LEFT JOIN (왼쪽은 모두, 오른쪽은 매칭될 때만)
SELECT e.emp_id, e.name, d.dept_name
FROM employees e
LEFT JOIN departments d
    ON e.dept_id = d.dept_id;


-- 3. RIGHT JOIN (오른쪽은 모두, 왼쪽은 매칭될 때만)
SELECT e.emp_id, e.name, d.dept_name
FROM employees e
RIGHT JOIN departments d
    ON e.dept_id = d.dept_id;


-- 4. FULL OUTER JOIN (양쪽 모두, 매칭되면 합치고 없으면 NULL)
SELECT e.emp_id, e.name, d.dept_name
FROM employees e
FULL OUTER JOIN departments d
    ON e.dept_id = d.dept_id;


-- 5. CROSS JOIN (모든 조합 생성 = 곱집합)
SELECT e.emp_id, d.dept_name
FROM employees e
CROSS JOIN departments d;


-- 6. SELF JOIN (자기 자신과 조인)
SELECT e1.emp_id, e1.name, e2.name AS manager_name
FROM employees e1
LEFT JOIN employees e2
    ON e1.manager_id = e2.emp_id;
참고로 Full Outer Join == Left Join + Union + Right Join 이다.
1-8 단일행 서브쿼리와 다중행 서브쿼리 + 상관 서브쿼리
-- 1. 단일행 서브쿼리 (결과가 1개 행/1개 값)
-- 예: 가장 높은 급여를 받는 직원 조회
SELECT *
FROM employees
WHERE salary = (
    SELECT MAX(salary)
    FROM employees
);


-- 2. 다중행 서브쿼리 (결과가 여러 행)
-- 예: 급여 상위 3명(emp_id)을 가진 직원만 조회
SELECT *
FROM employees
WHERE emp_id IN (
    SELECT emp_id
    FROM employees
    ORDER BY salary DESC
    FETCH FIRST 3 ROWS ONLY
);

-- 상관 서브쿼리 (Correlation Subquery)
-- 서브쿼리가 바깥 쿼리의 각 행을 참조하면서 반복 실행됨

-- 예: 각 직원의 부서 평균 급여보다 높은 직원만 조회
SELECT e.emp_id, e.name, e.salary, e.dept
FROM employees e
WHERE e.salary > (
    SELECT AVG(salary)
    FROM employees
    WHERE dept = e.dept   -- 바깥 쿼리의 값(dept)을 참조
);
1-9 집합 연산
-- 1. UNION (중복 제거 후 합집합)
SELECT emp_id FROM employees_2023
UNION
SELECT emp_id FROM employees_2024;


-- 2. UNION ALL (중복 포함한 합집합)
SELECT emp_id FROM employees_2023
UNION ALL
SELECT emp_id FROM employees_2024;


-- 3. INTERSECT (교집합)
SELECT emp_id FROM employees_2023
INTERSECT
SELECT emp_id FROM employees_2024;


-- 4. MINUS (Oracle) / EXCEPT (PostgreSQL)
-- Oracle: 2023에는 있지만 2024에는 없는 직원
SELECT emp_id FROM employees_2023
MINUS
SELECT emp_id FROM employees_2024;
1-10 Coalesce
-- COALESCE: NULL을 다른 값으로 대체하는 함수
-- 여러 값 중 NULL이 아닌 첫 번째 값을 반환

-- 1. 기본 예시: NULL이면 'N/A'로 대체
SELECT COALESCE(phone, 'N/A') AS phone_display
FROM employees;


-- 2. 여러 후보 중 첫 번째 NULL이 아닌 값 선택
-- nickname -> name -> 'Unknown' 순으로 선택
SELECT COALESCE(nickname, name, 'Unknown') AS display_name
FROM users;
1-11 윈도우 함수
-- 1. ROW_NUMBER: 각 행에 고유한 순번 부여
SELECT emp_id, name, salary,
       ROW_NUMBER() OVER (ORDER BY salary DESC) AS rn
FROM employees;


-- 2. RANK: 동일 값은 동일 순위, 다음 순위는 건너뜀(1,1,3...)
SELECT emp_id, name, salary,
       RANK() OVER (ORDER BY salary DESC) AS rk
FROM employees;


-- 3. DENSE_RANK: 동일 값은 동일 순위, 번호 건너뛰지 않음(1,1,2...)
SELECT emp_id, name, salary,
       DENSE_RANK() OVER (ORDER BY salary DESC) AS dr
FROM employees;


-- 4. SUM OVER: 누적합 (선형 집계)
SELECT emp_id, salary,
       SUM(salary) OVER (ORDER BY emp_id) AS running_total
FROM employees;


-- 5. PARTITION BY: 그룹별 윈도우 연산
SELECT dept, emp_id, salary,
       AVG(salary) OVER (PARTITION BY dept) AS dept_avg
FROM employees;
1-12 누계합, 이동평균
-- 1. 누계합(Running Total, Cumulative Sum)
SELECT emp_id,
       salary,
       SUM(salary) OVER (ORDER BY emp_id) AS cumulative_salary
FROM employees;


-- 2. 이동평균(Moving Average, Rolling Average)
-- 최근 3개 행 기준 이동평균 예시
SELECT emp_id,
       salary,
       AVG(salary) OVER (
           ORDER BY emp_id
           ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
       ) AS moving_avg_3
FROM employees;
1-13 그룹 별 값이 차지하는 비율
-- 파티션(그룹)별 비율 계산
-- 각 부서(dept) 안에서 직원의 salary가 차지하는 비율

SELECT dept,
       emp_id,
       salary,
       salary / SUM(salary) OVER (PARTITION BY dept) AS salary_ratio
FROM employees;
1-14 LAG, LEAD
-- 1. LAG: 이전 행의 값을 가져오기
SELECT emp_id,
       salary,
       LAG(salary, 1) OVER (ORDER BY emp_id) AS prev_salary
FROM employees;


-- 2. LEAD: 다음 행의 값을 가져오기
SELECT emp_id,
       salary,
       LEAD(salary, 1) OVER (ORDER BY emp_id) AS next_salary
FROM employees;
1-15 문자, 시간, CASE
-- 문자열 길이
SELECT LENGTH(name) AS len
FROM employees;

-- 문자열 일부 추출
SELECT SUBSTR(name, 1, 3) AS first_three
FROM employees;

-- 대문자/소문자 변환
SELECT UPPER(name), LOWER(name)
FROM employees;

-- 문자열 결합
SELECT CONCAT(first_name, ' ', last_name) AS full_name
FROM employees;

-- 공백 제거
SELECT TRIM('   hello   ') AS trimmed;


-- 오늘 날짜 (Oracle: SYSDATE, PostgreSQL/MySQL: CURRENT_DATE)
SELECT SYSDATE AS today
FROM dual;

-- 날짜 + 7일
SELECT SYSDATE + 7 AS next_week
FROM dual;

-- 두 날짜 차이(일 단위)
SELECT end_date - start_date AS days_diff
FROM projects;

-- 날짜의 특정 부분 추출
SELECT EXTRACT(YEAR FROM hire_date) AS hire_year,
       EXTRACT(MONTH FROM hire_date) AS hire_month
FROM employees;


-- 조건에 따라 값 분류
SELECT emp_id,
       salary,
       CASE
           WHEN salary >= 6000 THEN 'High'
           WHEN salary >= 4000 THEN 'Medium'
           ELSE 'Low'
       END AS salary_level
FROM employees;

-- NULL 처리에도 사용 가능
SELECT emp_id,
       CASE
           WHEN phone IS NULL THEN 'No Phone'
           ELSE phone
       END AS phone_display
FROM employees;
1-16 Grouping과 Rolling
-- 부서별 급여 합 + 전체 총합
SELECT dept,
       job,
       SUM(salary) AS total_salary,
       GROUPING(dept) AS grp_dept,
       GROUPING(job) AS grp_job
FROM employees
GROUP BY ROLLUP (dept, job);

-- GROUPING(dept) = 1 → dept가 총합(=NULL로 표시되는 집계 행)
-- GROUPING(job)  = 1 → job이 총합 행

-- dept → job 순서로 단계적 부분합 생성
SELECT dept,
       job,
       SUM(salary) AS total_salary
FROM employees
GROUP BY ROLLUP (dept, job);

-- 결과 예시 형태(개념)
-- dept   | job      | total_salary
-- ---------------------------------
-- IT     | dev      | 10000
-- IT     | tester   | 8000
-- IT     | NULL     | 18000   ← IT 부서 subtotal
-- HR     | analyst  | 7000
-- HR     | NULL     | 7000    ← HR 부서 subtotal
-- NULL   | NULL     | 25000   ← 전체 total
1-17 CTE와 재귀 CTE (조직도)
-- CTE
WITH high_salary AS (
    SELECT emp_id, name, salary
    FROM employees
    WHERE salary >= 5000
)
SELECT *
FROM high_salary;


-- Recursive CTE
WITH RECURSIVE org AS (
    -- Anchor: 최고 관리자(루트)
    SELECT emp_id, name, manager_id, 1 AS level
    FROM employees
    WHERE manager_id IS NULL

    UNION ALL

    -- Recursive: 하위 직원 연결
    SELECT e.emp_id, e.name, e.manager_id, o.level + 1
    FROM employees e
    JOIN org o ON e.manager_id = o.emp_id
)
SELECT *
FROM org
ORDER BY level, emp_id;
1-18 시쿼스, 트리거, 자동 적용 트리거, 프로시저
-- 시퀀스 생성
CREATE SEQUENCE seq_emp
START WITH 1
INCREMENT BY 1;

-- 시퀀스 사용 예 (INSERT)
INSERT INTO employees (emp_id, name)
VALUES (seq_emp.NEXTVAL, 'Kim');


--트리거

-- 예: INSERT 시 생성일자(created_at) 자동 기록
CREATE OR REPLACE TRIGGER trg_set_created_at
BEFORE INSERT ON employees
FOR EACH ROW
BEGIN
    :NEW.created_at := SYSDATE;
END;


-- 예: 시퀀스 자동 적용 트리거 (emp_id 자동 세팅)
CREATE OR REPLACE TRIGGER trg_emp_id
BEFORE INSERT ON employees
FOR EACH ROW
BEGIN
    :NEW.emp_id := seq_emp.NEXTVAL;
END;


--프로시저

-- 직원 급여 인상 프로시저 예시
CREATE OR REPLACE PROCEDURE raise_salary (
    p_emp_id IN employees.emp_id%TYPE,
    p_amount IN NUMBER
)
AS
BEGIN
    UPDATE employees
    SET salary = salary + p_amount
    WHERE emp_id = p_emp_id;
END;


-- 프로시저 호출
BEGIN
    raise_salary(1001, 500);
END;
1-19 권한
-- SELECT 권한 부여
GRANT SELECT ON employees TO user1;

-- INSERT, UPDATE 권한 부여
GRANT INSERT, UPDATE ON employees TO user1;

-- 모든 권한 부여 (주의!)
GRANT ALL PRIVILEGES ON employees TO user1;

-- 권한 회수
REVOKE SELECT ON employees FROM user1;
REVOKE ALL PRIVILEGES ON employees FROM user1;

-- Role
-- 롤 생성
CREATE ROLE read_only;

-- 롤에 권한 부여
GRANT SELECT ON employees TO read_only;

-- 롤을 사용자에게 부여
GRANT read_only TO user1;

-- 사용자 생성
CREATE USER user1 IDENTIFIED BY password123;

-- 패스워드 변경
ALTER USER user1 IDENTIFIED BY new_password;

-- 필요 권한만 부여 (예: SELECT만 필요하면 SELECT만)
GRANT SELECT ON sensitive_table TO analyst_user;

-- 쓰기가 필요 없는데 INSERT/UPDATE를 주지 않음
REVOKE INSERT, UPDATE ON sensitive_table FROM analyst_user;
2. Indexing
2-1 B+Tree
<특징>
- 리프 노드에만 데이터가 저장됨
- 리프 노드들이 Linked List로 연결 -> 범위 검색 빠름
- 트리 Depth가 낮음 -> 균일한 검색
<장점>
- 범위 검색 가능, Order By, Group By 성능 좋음, 균형 트리 구조라서 성능 안정적
<단점>
- 특정 경우 Hash보다 느릴 수 있다, 랜덤 I/O 발생, 너무 많은 인덱스가 있으면 DML 성능 저하
2-2 Hash
<특징 == 장점>
- 정합 검색(=) 매~우 빠름
- 데이터 양이 많아도 동일한 검색 속도
<단점>
- 범위 조건 불가능
- 정렬, Order By 불가능
- 해시 충돌 가능성
2-3 Bitmap
<특징>
- Oracle에서 사용
- 각 값에 대해 Bitmap 형태로 존재 유무를 기록한다
- 중복 값이 매우 많은 컬럼 (성별, 지역)에 적합
- DW에서 자주 사용
2-4 Full-Text 인덱스
- 텍스트 검색, 자연어 검색 최적화
- "문장 안에서 특정 단어 포함 여부" <- 이런 검색에 유리
2-5 Spatial 인덱스
- 위치 기반 데이터 최적화
- R-Tree 구조
3. KEY
3-1. Primary Key - 각 행을 식별하는 대표 키 / 중복x Null x
3-2. Candidate Key - Primary Key가 될 수 있는 키 / 중복x Null x
3-3. Unique Key - 중복x Null o 인 키 ex) 전화번호, 닉네임 등 -> 한 테이블에 여러 개 있을 수 있다
3-4. Alternate Key - Primary Key가 될 수 있는 키 중 Primary Key가 아닌 것
3-5 Foreign Key - 다른 테이블의 Primary Key 또는 Unique Key를 참조하는 키
3-6 Super Key - 유일성을 만족하는 모든 속성의 집합
3-7 Composite Key - 둘 이상의 컬럼을 묶어 Primary Key 또는 Unique Key를 구성
4. 모델링
4-1 개념적 모델링 : ER Diagram, 요구사항 분석
4-2 논리적 모델링 : 정규화, 키 지정
4-3 물리적 모델링 : Indexing, Partitioning, View, Cache Table 등
5. ER 다이어그램 그리기
5-1 Entity : 저장할 대상 (테이블) - 네모
5-2 Attribute : Entity의 속성 - 타원
5-3 Relatioship : 1대1 1대n n대m 등 표현 - 마름모
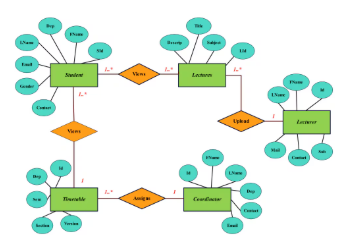
+ 다대다 관계 (ex: 학생 : 교과목) 는 제1, 3 정규화 법칙을 위반한다. 학생과 교과목 사이에 Enrollment 테이블을 만드는 것처럼 중간 테이블을 만들어서 기본 키를 Composite Key로 둔다(학생 id, 교과목 id)
+ 테이블에서 null 값이 많은 속성은 분리하는 것이 좋다
6. 정규화 - 데이터 중복 제거, 이상 현상 방지
이상 현상에는 삽입 이상, 갱신 이상, 삭제 이상 등이 있다.
6-1 1NF - 하나의 컬럼에는 원자값만 들어가야 한다.
6-2 2NF - 복합키가 기본키일 때 복합키의 일부 속성에만 종속된 속성은 제거해야 한다
6-3 3NF - 이행 함수 종속 제거 A-B B-C 형태의 연쇄적 종속을 제거한다.
6-4 BCNF - 모든 결정자는 후보키여야 한다.
7. 무결성
7-1 개체 무결성 : 기본키는 Not Null
7-2 참조 무결성 : 외래키는 기본키 참조
7-3 도메인 무결성 : 속성 값은 정의된 자료형, 범위 내에서 지정'CS' 카테고리의 다른 글
Apache Spark (0) 2025.11.26 Apache Kafka (0) 2025.11.26 면접을 위한 JAVA 정리 (0) 2025.11.17 면접을 위한 C 정리 (0) 2025.11.17 Singleton 패턴 (2) 2025.08.07